Fundamentos de ingeniería IA.
Un curso práctico, en español, para entender cómo funcionan los LLMs y construir con ellos: un playground, un chatbot con RAG, un agente que busca en la web y un sistema de investigación profunda.
PRÓXIMA COHORTE: POR ANUNCIAR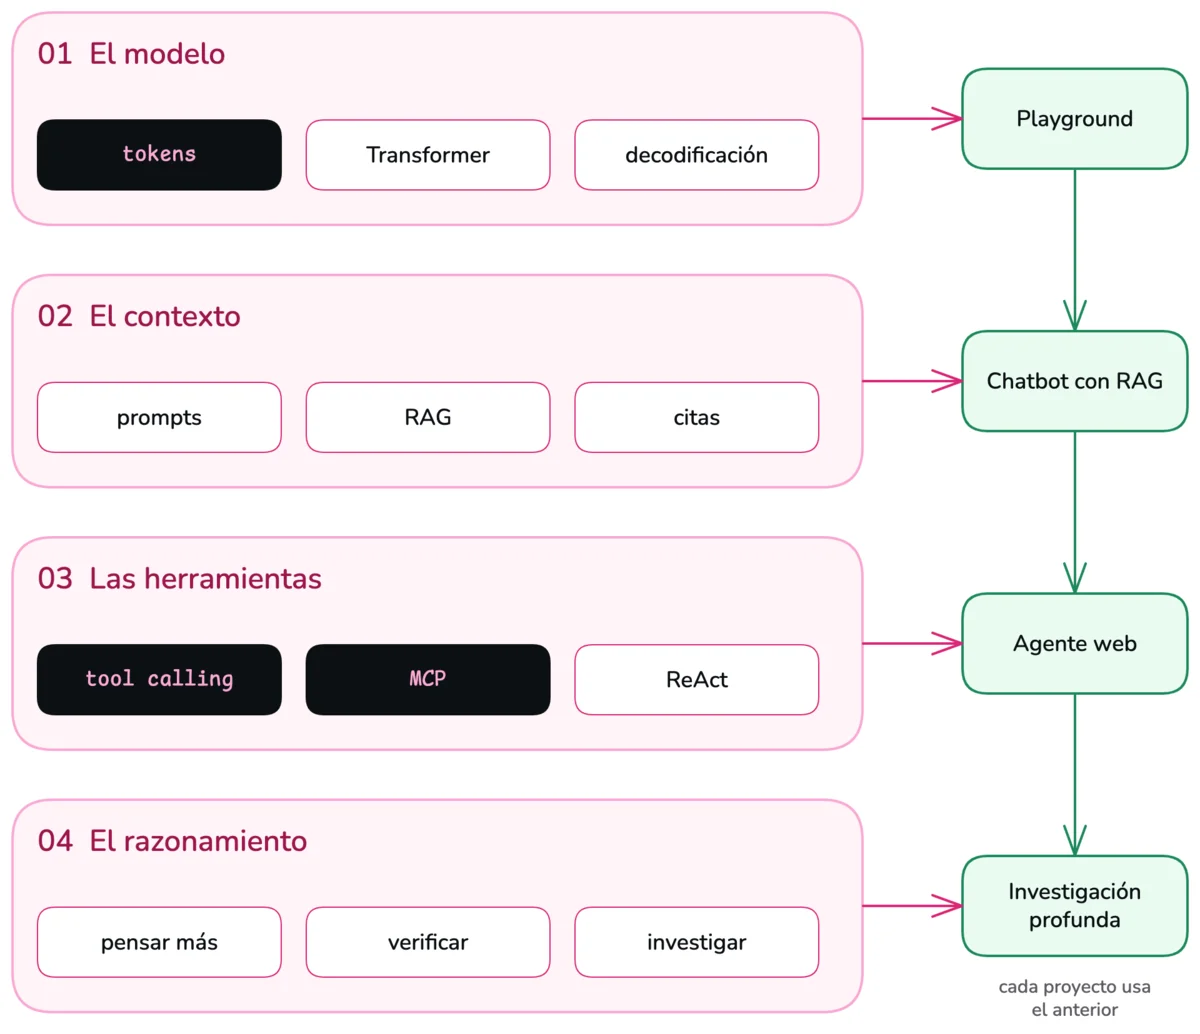
Deja de copiar tutoriales. Entiende lo que construyes.
Seis habilidades para trabajar con LLMs con criterio: saber qué pasa por dentro, qué técnica usar y cómo comprobar que funciona.
Entender un LLM por dentro
- Datos, tokens y Transformers, sin fórmulas.
- Cómo el modelo elige cada palabra.
- Qué hacen el SFT y el RLHF.
Diseñar el contexto
- Few-shot, chain-of-thought y prompts de rol.
- Qué entra en la ventana de contexto y en qué orden.
- Menos tokens, mejores respuestas.
Construir RAG
- Chunks, embeddings e índices vectoriales.
- Respuestas con citas a la fuente.
- Medir la fidelidad y la relevancia.
Diseñar agentes
- Workflows o agentes: cuándo usar cada uno.
- Tool calling y MCP.
- ReAct y sistemas multiagente.
Usar modelos de razonamiento
- Cuándo pagar por pensar más.
- Muestreo en paralelo y verificadores.
- Modelos abiertos en tu computador.
Elegir con criterio
- ¿Prompt, RAG o fine-tuning?
- ¿Qué modelo, a qué costo y con qué latencia?
- Evaluar antes de confiar en un resultado.
Cuatro sesiones, del modelo al agente.
Cada sesión en vivo cubre tres bloques y termina con una demo. Después, construyes esa demo en tu propio código.
Cómo funciona un LLM
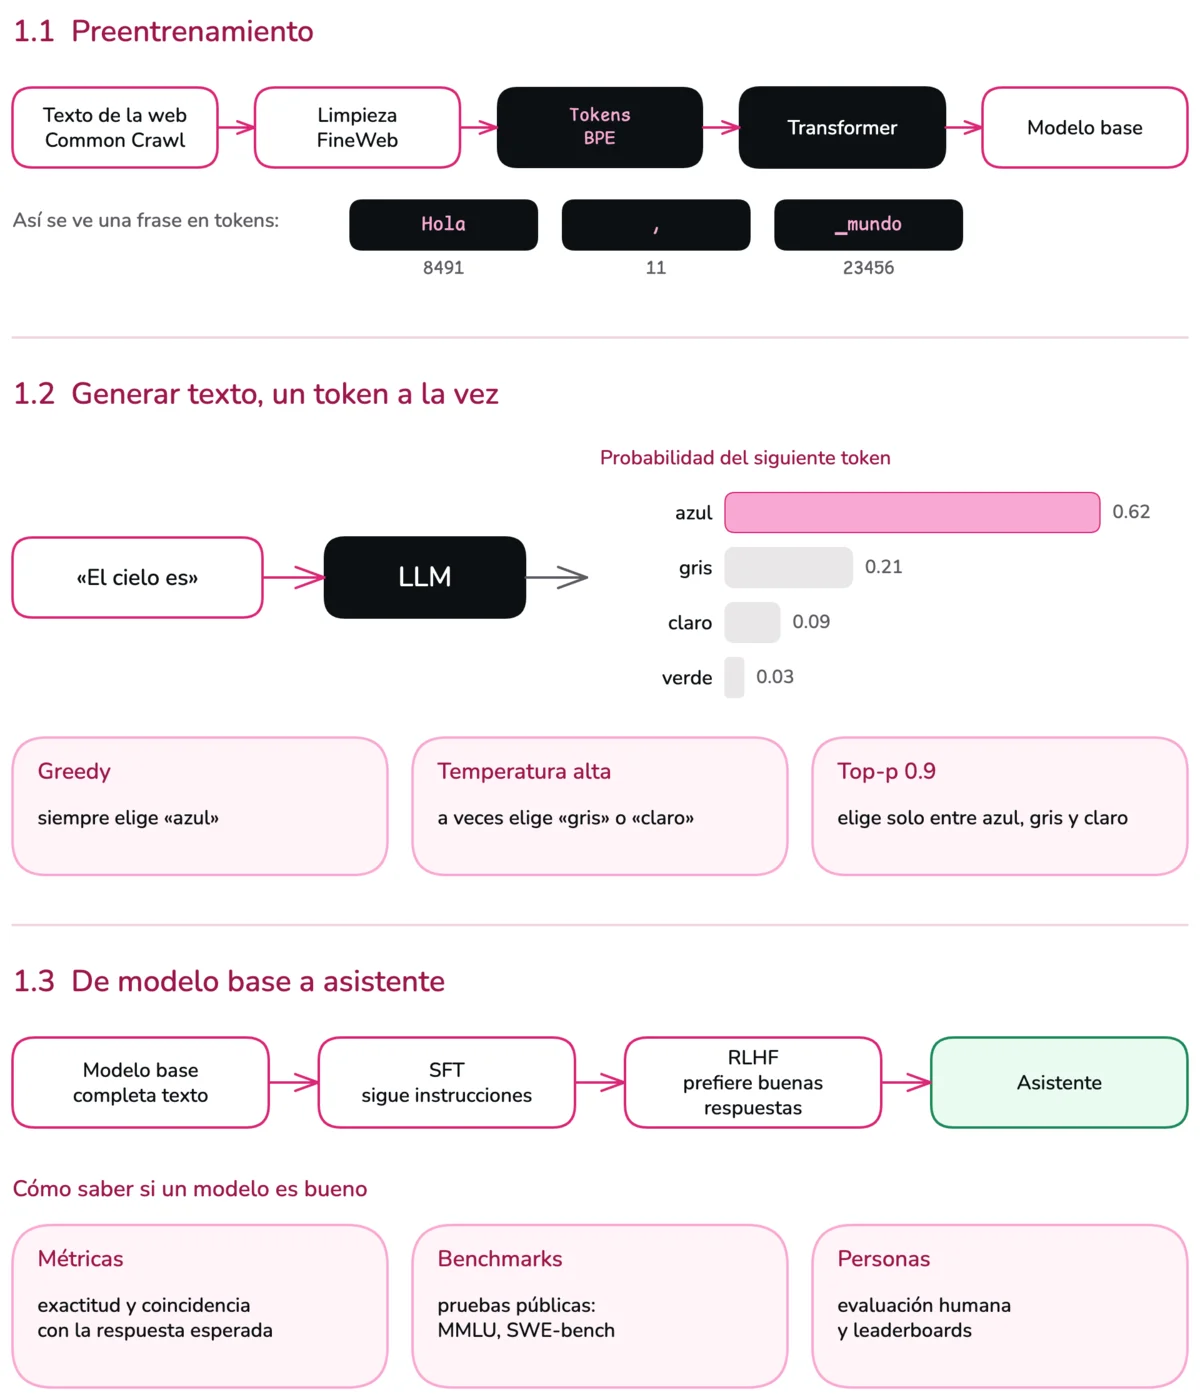
Preentrenamiento
- De dónde salen los datos: rastreo de la web, Common Crawl y limpieza con FineWeb.
- Tokenización: cómo el texto se convierte en números (BPE).
- La arquitectura Transformer y la atención, sin fórmulas.
- Las familias de modelos: Claude, GPT y Gemini; y los abiertos: Llama, Qwen, DeepSeek y Gemma.
Generar texto
- El modelo predice un token a la vez.
- Greedy y beam search.
- Temperatura, top-k y top-p: cuándo usar cada uno.
- Ventana de contexto, costo por token y latencia.
Postentrenamiento y evaluación
- Fine-tuning supervisado (SFT): de predecir texto a seguir instrucciones.
- RLHF y aprendizaje por refuerzo con recompensas verificables.
- Métricas, benchmarks y evaluación humana.
- Cómo leer un leaderboard sin engañarte.
Proyecto: Un playground de LLMs
- Envía la misma pregunta a varios modelos.
- Cambia la temperatura, top-k y top-p, y compara las respuestas.
- Mide los tokens, el costo y la latencia de cada llamada.
- Guarda cada prueba en una tabla para compararlas.
Prompts, contexto y RAG
Ingeniería de prompts y de contexto
- Zero-shot y few-shot.
- Chain-of-thought: pedirle al modelo que razone por pasos.
- Prompts de rol y con el contexto del usuario.
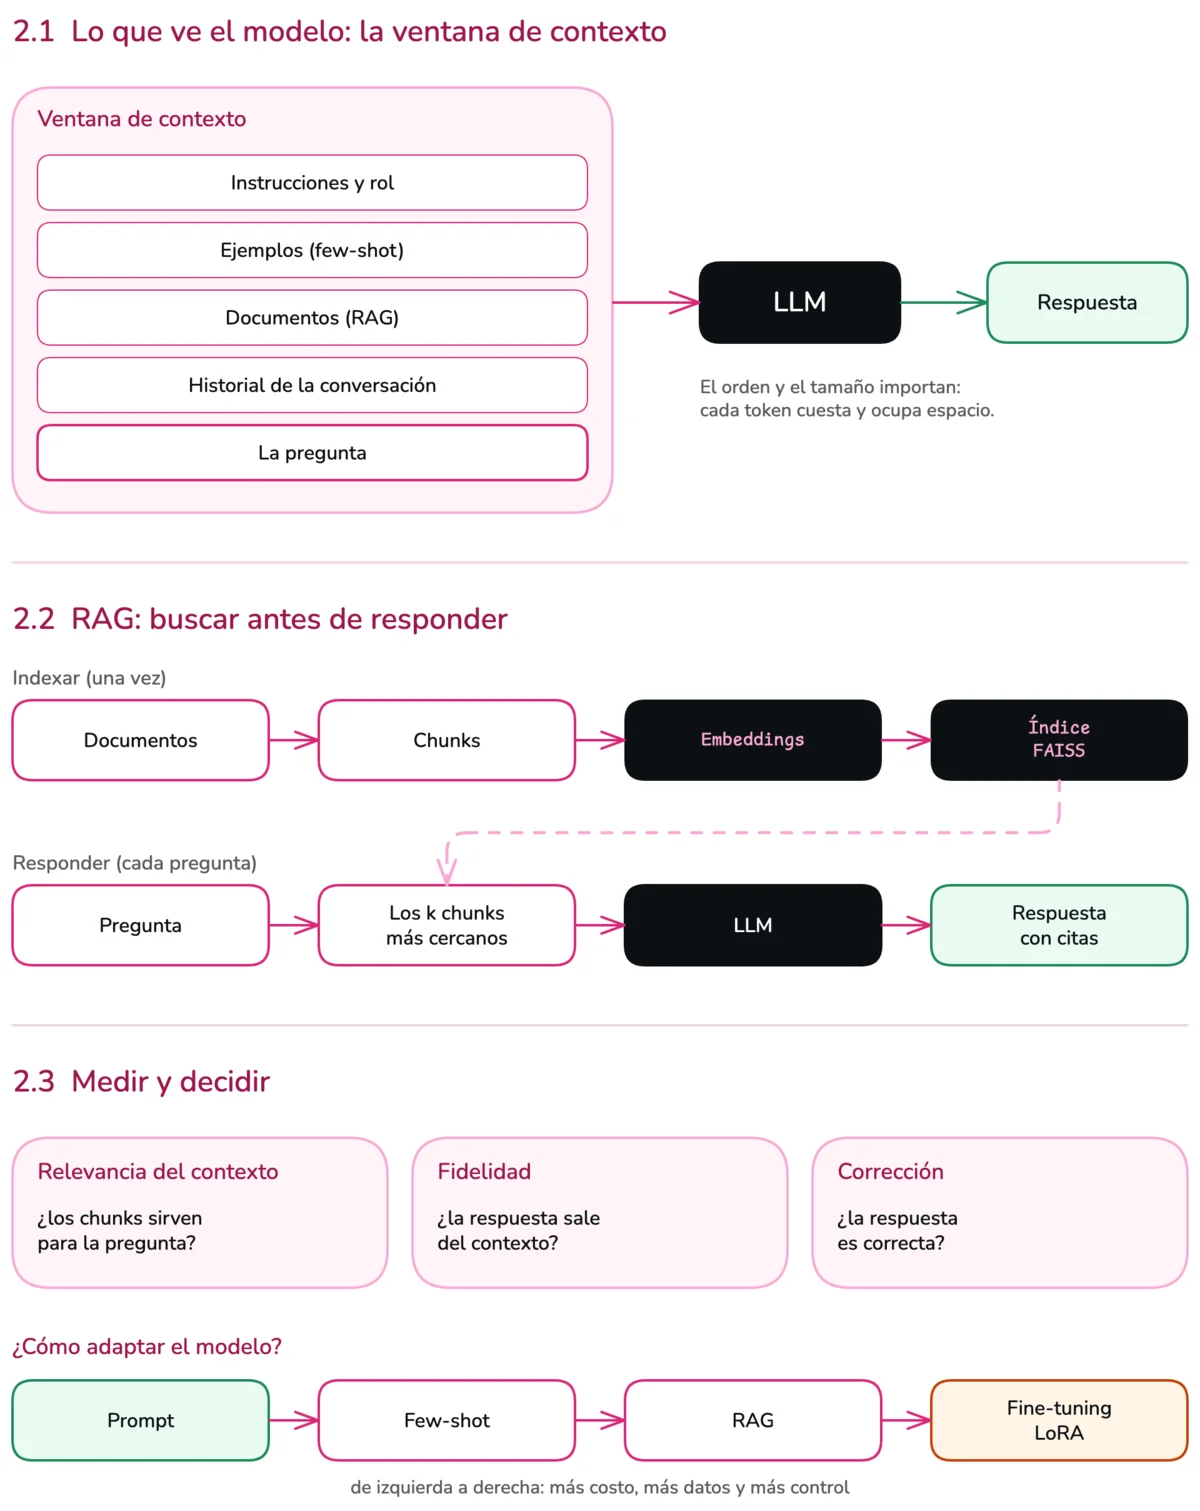
- Armar el contexto: instrucciones, ejemplos, documentos e historial.
Recuperación
- Leer documentos con reglas o con IA, y partirlos en chunks.
- Índices por palabras clave, de texto completo y vectoriales.
- Modelos de embeddings: cómo representan el significado.
- Búsqueda exacta y aproximada (ANN) con FAISS.
Generar, evaluar y ajustar
- Prompts para RAG: responder solo con el contexto y citar la fuente.
- Métricas: relevancia del contexto, fidelidad y corrección de la respuesta.
- Fine-tuning eficiente (PEFT): adapters y LoRA.
- ¿Prompt, RAG o fine-tuning? Cómo decidir.
Proyecto: Un chatbot de soporte con RAG
- Carga los manuales y las preguntas frecuentes de una empresa.
- Pártelos en chunks e indexa sus embeddings con FAISS.
- Responde preguntas citando el documento de origen.
- Mide la fidelidad y la relevancia de cada respuesta.
Agentes
De LLM a agente
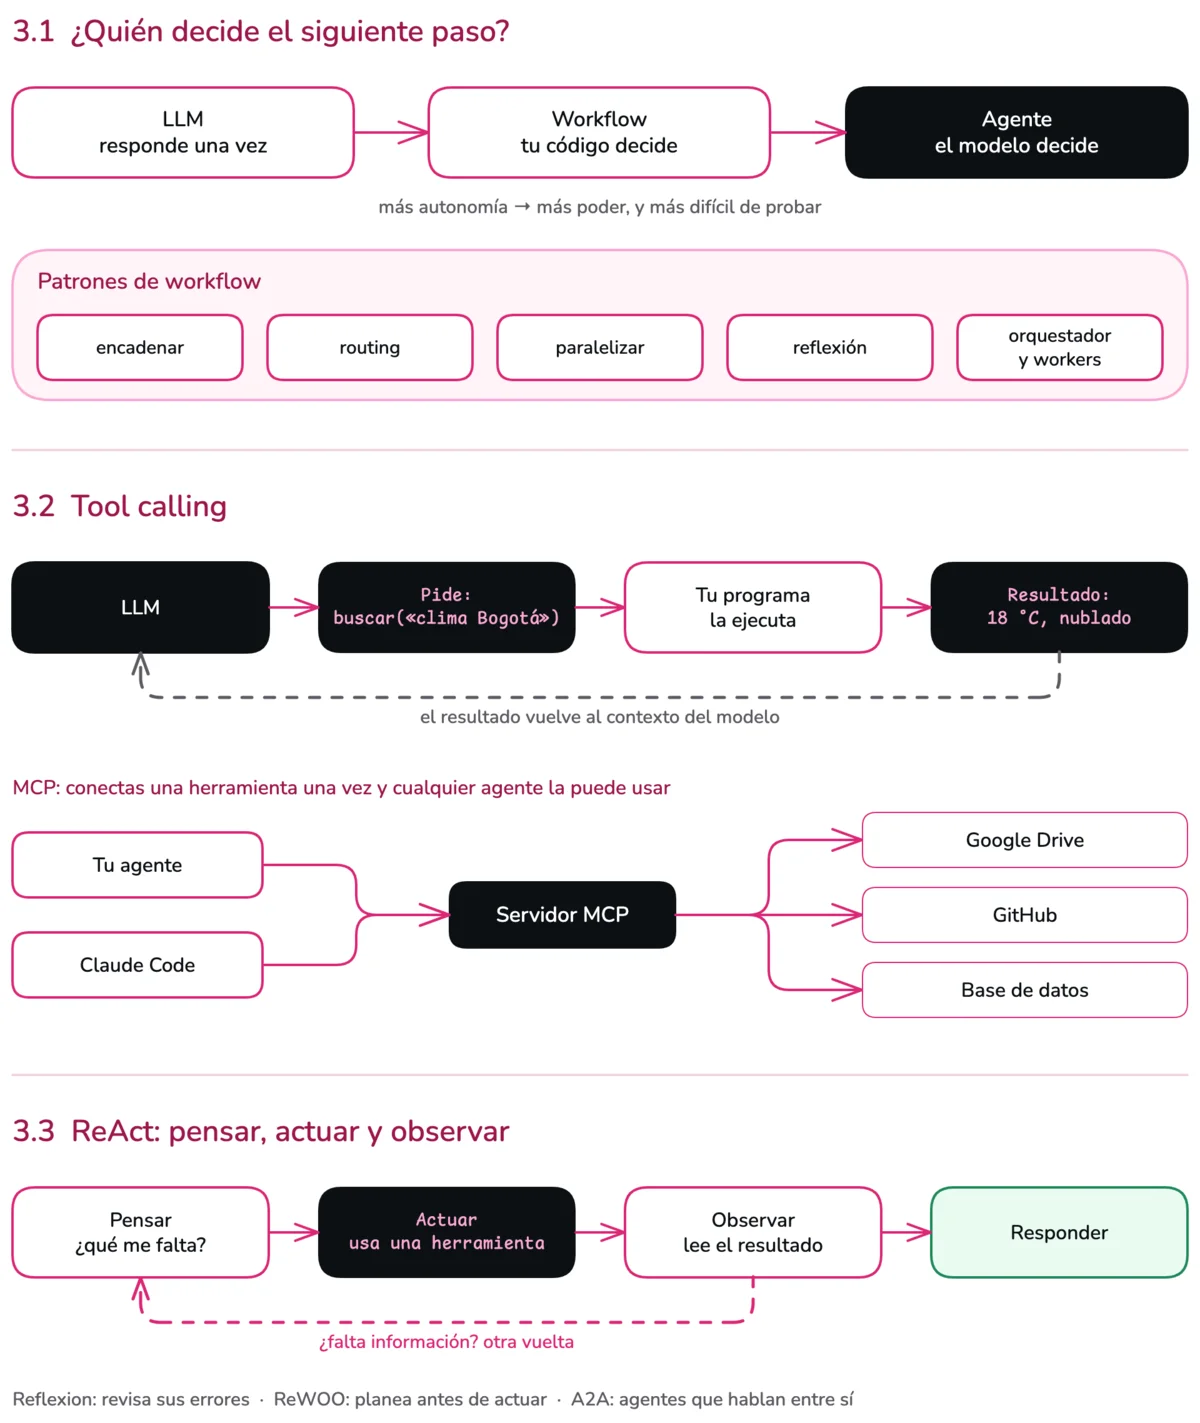
- LLM, workflow y agente: en qué se diferencian.
- Niveles de autonomía: quién decide el siguiente paso.
- Patrones de workflow: encadenar prompts, routing y paralelizar.
- Reflexión y el patrón orquestador-workers.
Herramientas
- Tool calling: definir, formatear y ejecutar una herramienta.
- Model Context Protocol (MCP): herramientas que se conectan una vez y sirven a cualquier agente.
- Errores, límites y permisos de cada herramienta.
Agentes de varios pasos
- Planear: ReAct, Reflexion y ReWOO.
- Búsqueda en árbol para agentes.
- Sistemas multiagente y el protocolo A2A.
- Evaluar un agente: resultado, pasos y costo.
Proyecto: Un agente que busca en la web
- Dale al agente herramientas para buscar y leer páginas.
- Deja que decida qué buscar y cuándo parar.
- Responde con las fuentes de cada dato, como Perplexity.
- Evalúa sus respuestas con un conjunto de preguntas.
Razonamiento e investigación profunda
Modelos que piensan
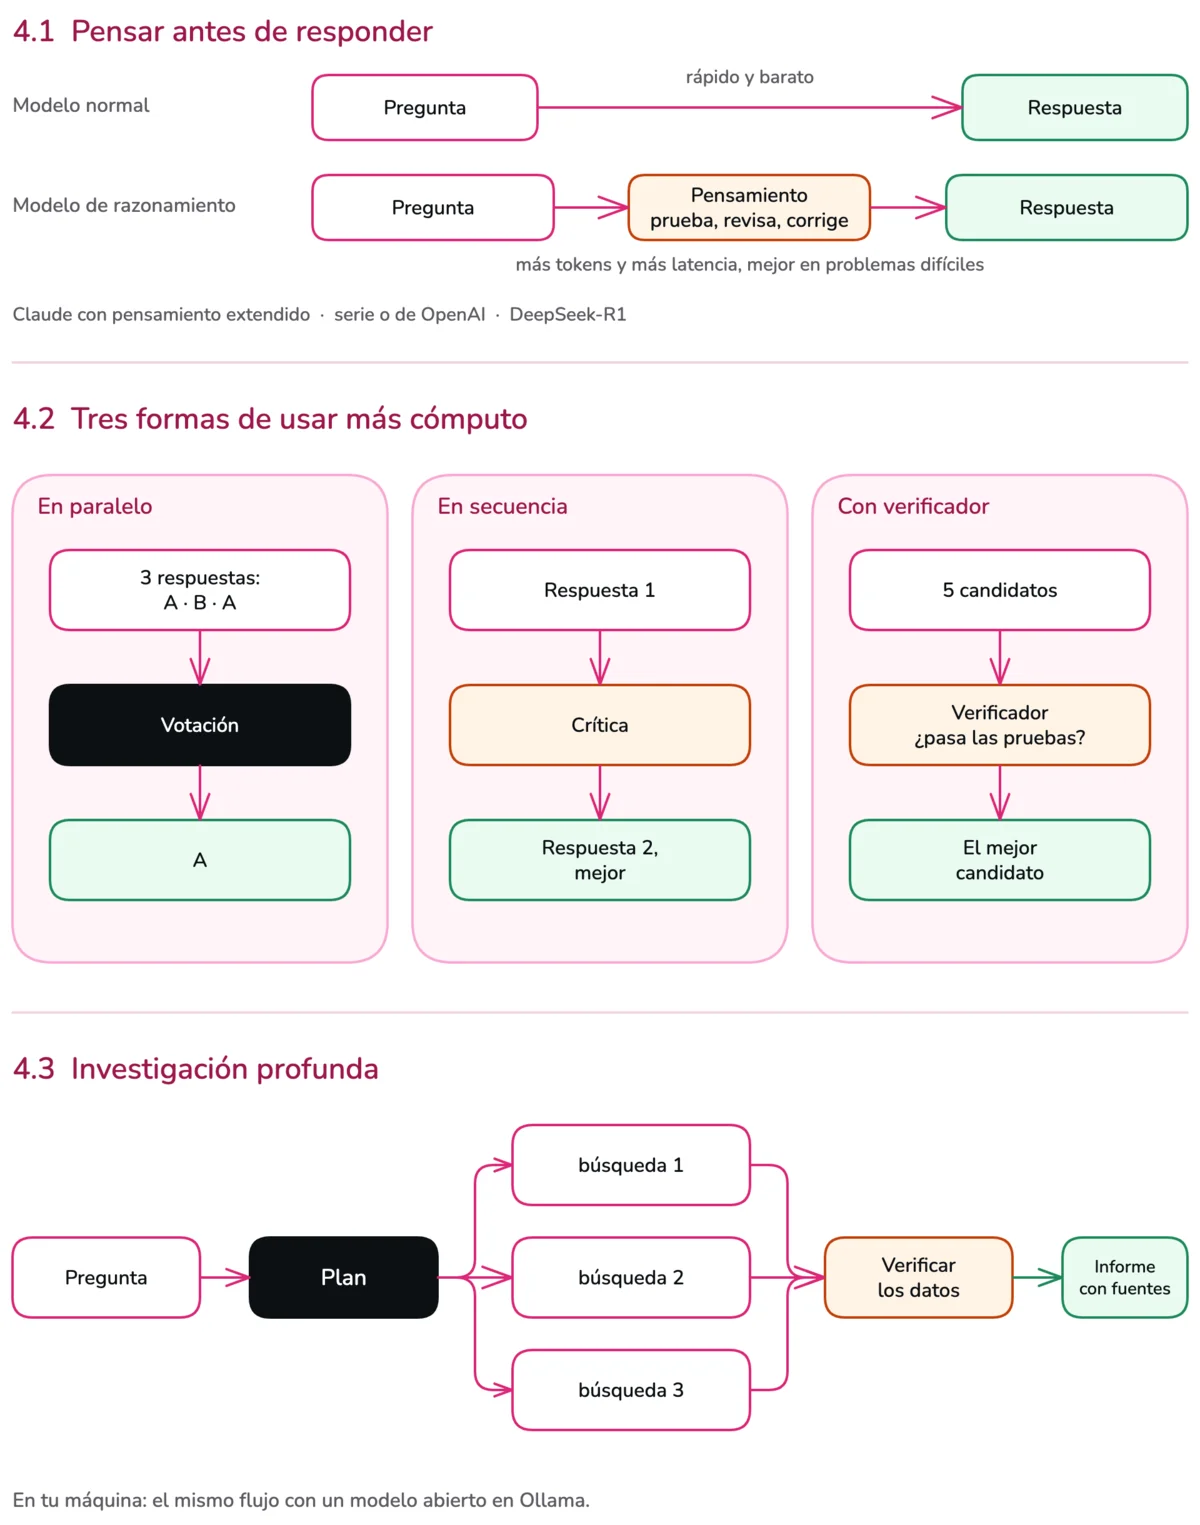
- Qué cambia en un modelo de razonamiento.
- Claude con pensamiento extendido, la serie o de OpenAI y DeepSeek-R1.
- Cuándo vale la pena el costo y la latencia extra.
Más cómputo al responder
- Escalar la inferencia: pensar más para responder mejor.
- Muestreo en paralelo y muestreo secuencial.
- Tree of Thoughts.
- Buscar contra un verificador.
Cómo se entrenan y cómo correrlos en tu máquina
- SFT con datos de razonamiento (STaR).
- Aprendizaje por refuerzo con verificadores.
- Modelos de recompensa: ORM y PRM.
- Correr un modelo abierto en tu computador con Ollama.
Proyecto: Investigación profunda
- Convierte una pregunta en un plan de búsquedas.
- Ejecuta las búsquedas en paralelo con el agente de la sesión 3.
- Verifica los datos con un modelo de razonamiento.
- Escribe un informe con fuentes, y prueba la misma tarea con un modelo local.
Cuatro sistemas, cada uno sobre el anterior.
Cada proyecto usa lo que construiste la semana anterior. Al final tienes cuatro sistemas en tu repositorio que puedes mostrar en una entrevista o en tu empresa.
Playground
Varios modelos y estrategias de decodificación, con el costo y la latencia de cada llamada.
Chatbot con RAG
Un asistente de soporte que responde con los documentos de una empresa y cita la fuente.
Agente web
Un agente que decide qué buscar, lee las páginas y responde con fuentes.
Investigación profunda
Un plan de búsquedas en paralelo, verificado por un modelo de razonamiento, que termina en un informe.
Aprende de quien construye con LLMs cada día.
Victor Hazbun
Fundador · Bonsai LabsVictor construye software desde 2014. Trabajó como contratista para Priceline y GoDaddy, y como líder técnico formó a desarrolladores con sesiones en pareja, revisiones de código y planes de estudio. Desde 2023 diseña y opera sistemas de IA en producción: agentes, RAG, guardrails y evaluaciones. Hoy dirige Bonsai Labs, donde construye UTMKit y CodeWarden. En este curso enseña las bases que usa en cada uno de esos sistemas.
Qué necesitas antes de empezar
- Python básico para los proyectos: entornos virtuales,
pipy ejecutar scripts. - Python 3.11 o superior y Git instalados.
- Una clave de API de Claude. Te explicamos cómo crearla en la primera sesión.
Qué recibes al inscribirte
- Cuatro sesiones en vivo con preguntas y respuestas.
- Grabación de cada sesión y el código de cada demo.
- Una comunidad con tu cohorte para avanzar en grupo.
- Horas de consulta opcionales sobre el material o tu proyecto.
- Certificado de finalización para tu perfil de LinkedIn.
Antes de inscribirte.
¿El curso es en español?
Sí. Las sesiones, los materiales y los proyectos están en español. Las herramientas y su documentación están en inglés, y te explicamos cada término.
¿El curso es en línea?
Sí. Todas las sesiones son en vivo y en línea: te conectas desde Colombia o desde cualquier otro país.
¿Qué necesito saber antes?
Para los proyectos, Python básico: entornos virtuales, pip y ejecutar scripts. Si no programas, puedes seguir las sesiones en vivo y entender cada tema.
¿Cuánto tiempo necesito?
Son cuatro sesiones en vivo de 3 horas, una por semana. Con los proyectos, calcula entre 4 y 7 horas por semana.
¿Qué pasa si no puedo ir a una sesión?
Todas las sesiones se graban. Puedes verlas cuando quieras y seguir con los proyectos igual que el resto de la cohorte.
¿Qué modelos usamos?
Claude es el modelo principal de los proyectos. Para comparar, usamos otros modelos por API y un modelo abierto que corre en tu computador.
¿En qué se diferencia de «Construye sistemas IA para producción»?
Este curso enseña cómo funcionan los LLMs y cómo construir con ellos. Construye sistemas IA para producción enseña a llevar esos sistemas a un servicio confiable. Te recomendamos empezar por este.
¿Mi empresa puede pagar el curso?
Sí. Te enviamos una factura para que la presentes a tu presupuesto de formación.
¿Tienes otra pregunta?
Escríbenos a contact@bonsailabs.io.
Entiende los LLMs. Después, construye con ellos.
Estamos definiendo la fecha y el precio de la primera cohorte. Escríbenos y te avisamos antes de abrir las inscripciones.