Construye sistemas IA para producción.
Un curso práctico, en español, para llevar un prototipo de IA a un servicio que aguanta usuarios reales: medido, seguro, con costo y latencia bajo control, y fácil de operar.
PRÓXIMA COHORTE: POR ANUNCIAR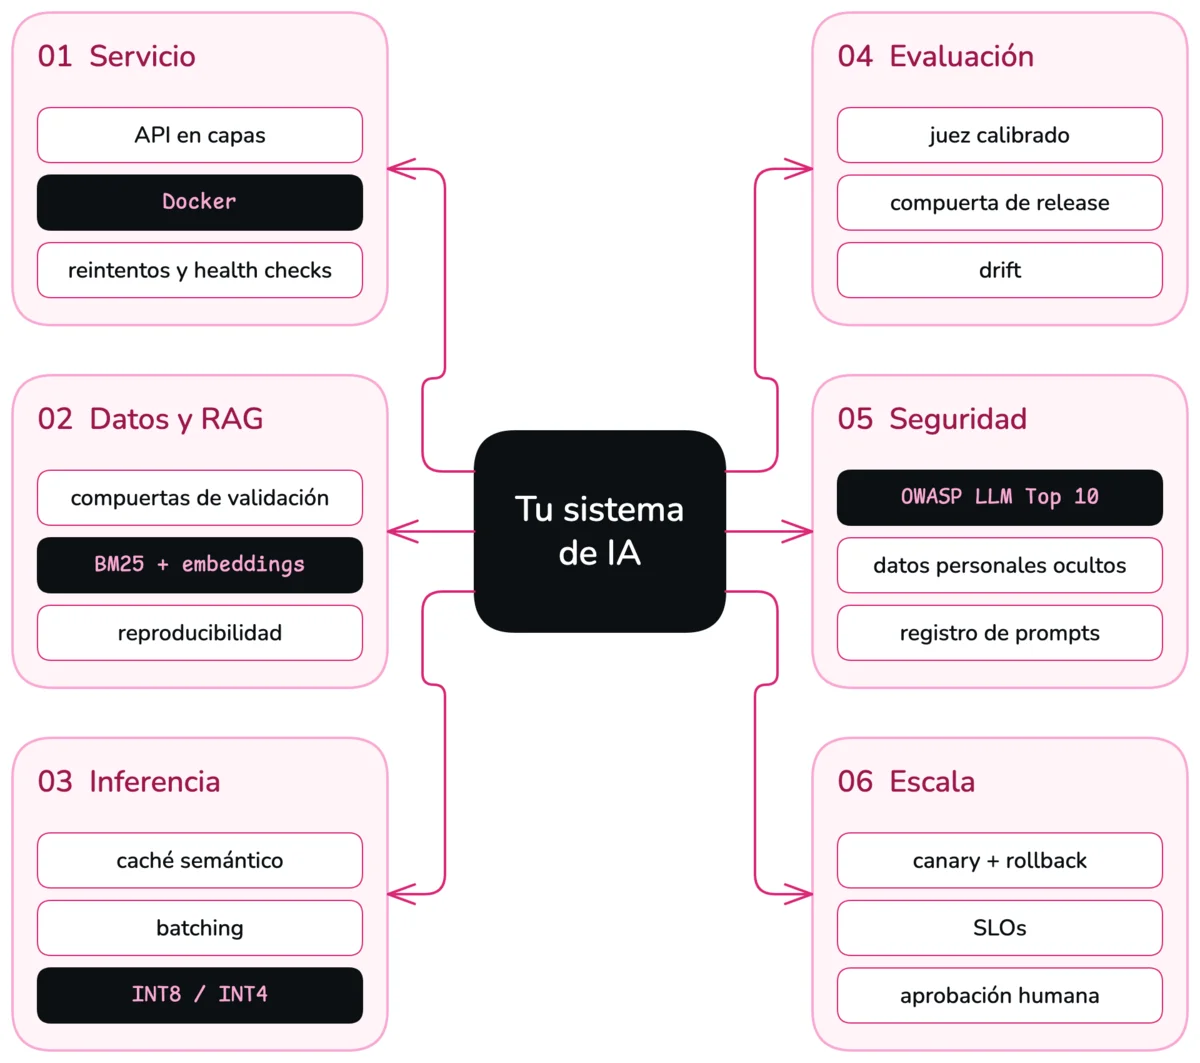
Del notebook a un sistema que puedes operar.
Seis habilidades, en el orden en que un sistema de IA las necesita al salir del prototipo. Cada una se practica con un proyecto.
Llevar un prototipo a servicio
- Un servicio en capas con FastAPI, a partir de un notebook.
- Modelos como artefactos versionados dentro de una imagen de Docker.
- Reintentos, health checks y logs estructurados.
Construir RAG para empresas
- Parsing, chunking, embeddings e índices.
- Búsqueda híbrida: BM25 + embeddings + reranking.
- Compuertas de calidad para los datos.
Bajar la latencia y el costo
- Medir p50 y p95 antes de optimizar.
- Caché, batching y cuantización.
- API pagada o GPU propia, con números.
Evaluar y monitorear
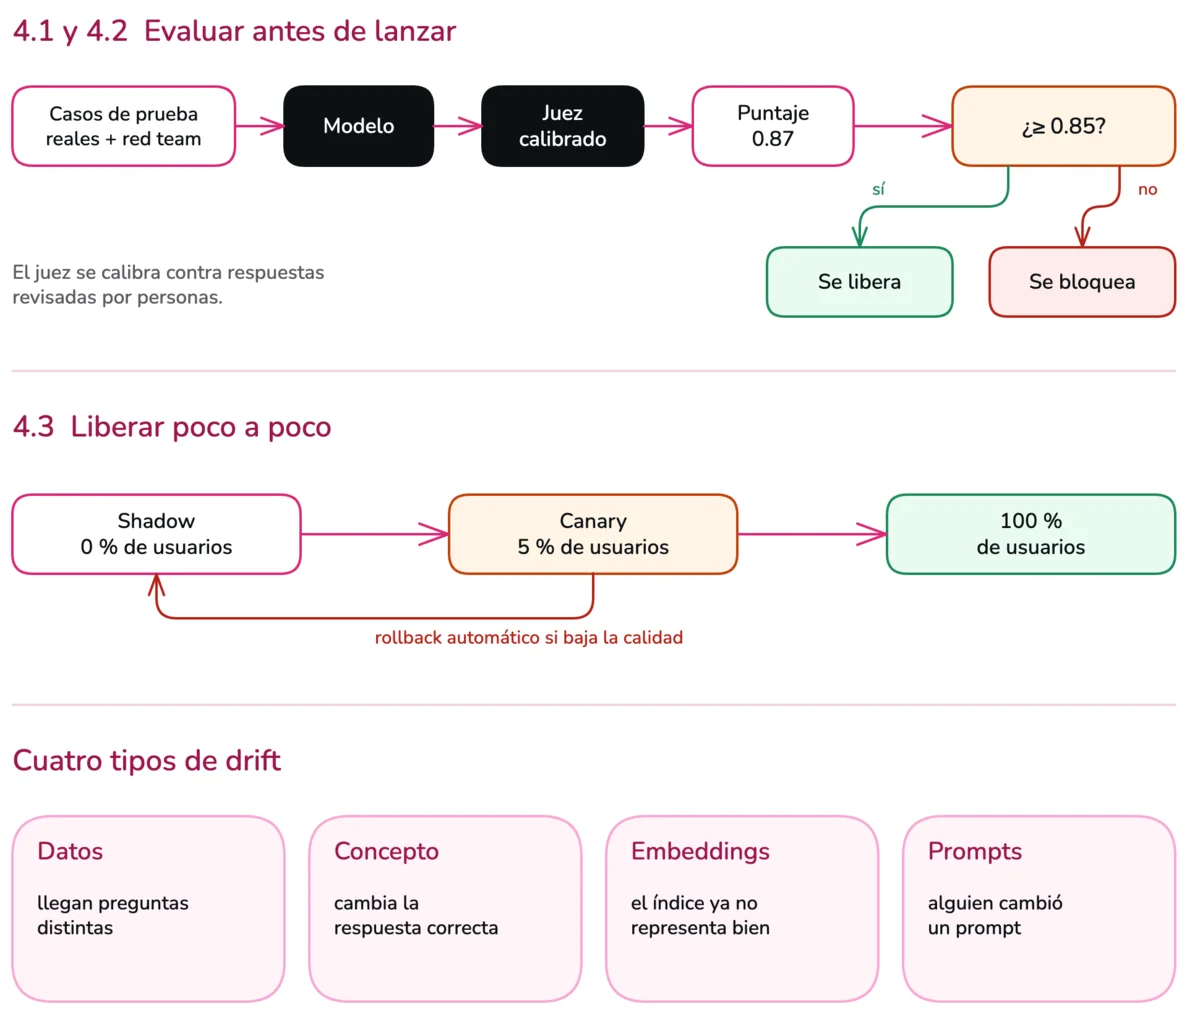
- Compuertas de calidad automáticas antes de cada release.
- Detectar pérdida de contexto y mal uso de herramientas.
- Encontrar el drift de calidad en producción.
Proteger y gobernar
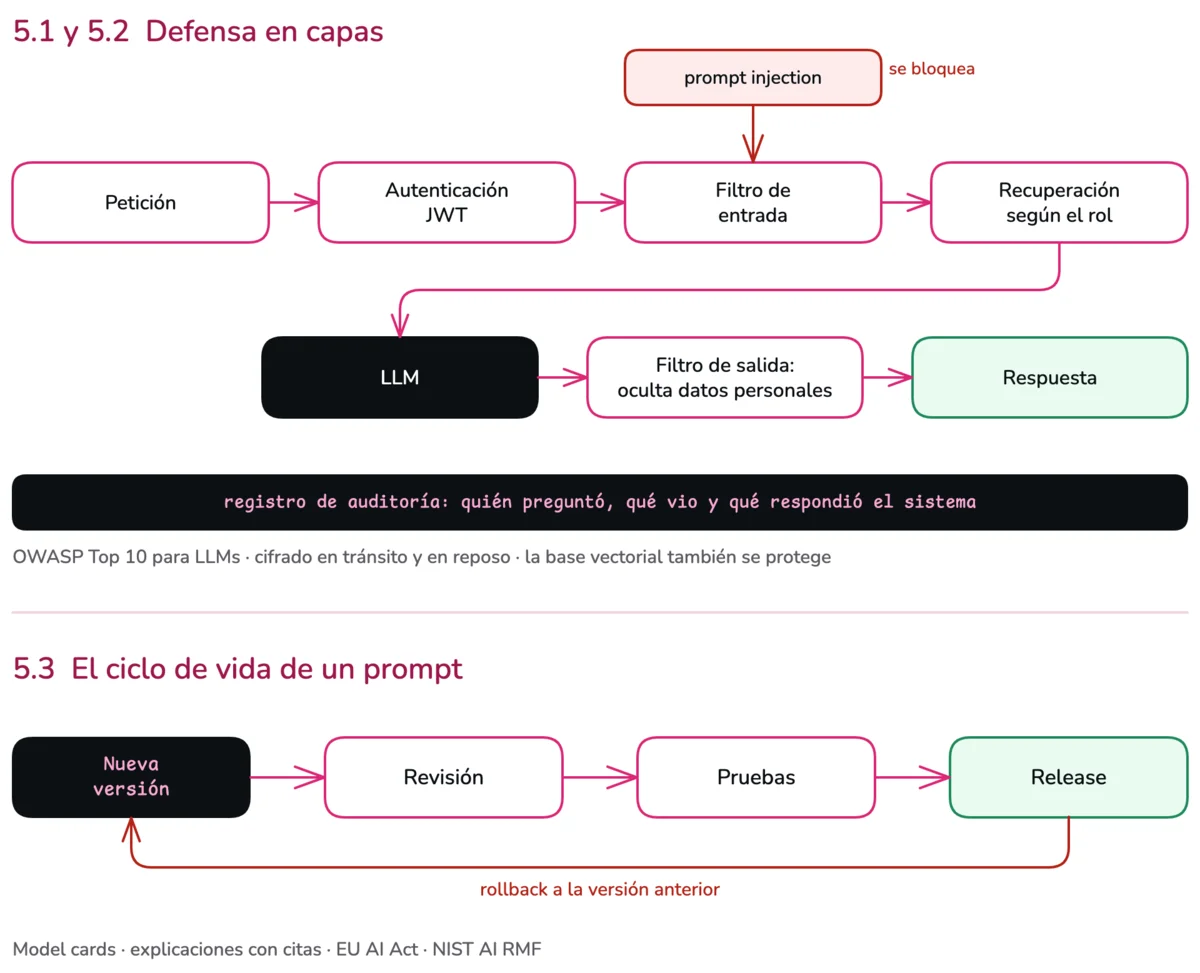
- Acceso a documentos según cada usuario.
- Defensas contra prompt injection y jailbreaks.
- Prompts versionados con revisión, pruebas y rollback.
Operar a escala
- Canary con rollback automático.
- Aprobación humana para acciones de agentes de alto riesgo.
- Arquitecturas que puedes explicar y justificar por su costo.
Seis sesiones, un mismo sistema que crece.
Cada sesión en vivo cubre tres bloques y termina con una demo. Después, llevas esa demo a tu propio código.
Del prototipo a producción
Arquitectura de sistemas de IA
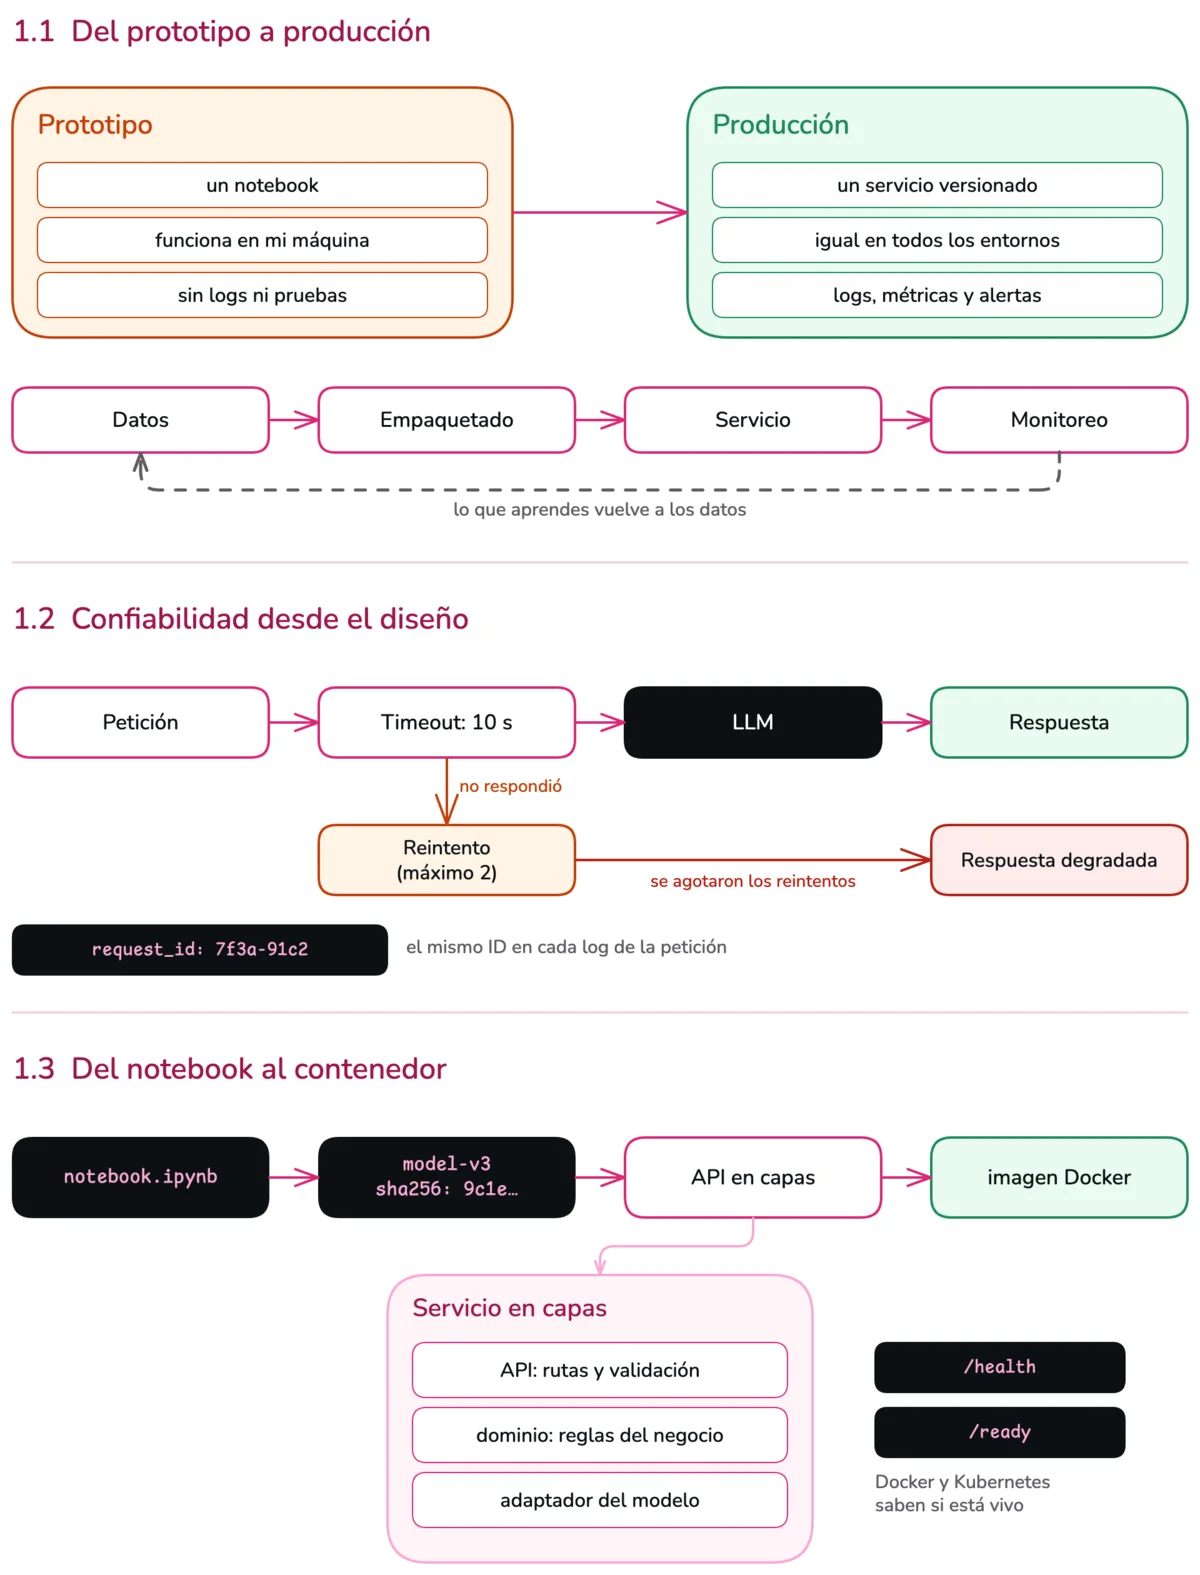
- Prototipo frente a producción, y el desfase entre entrenamiento y servicio (training/serving skew).
- El ciclo de vida: datos → empaquetado → servicio → monitoreo.
- Inferencia por lotes o en línea; monolito, microservicios o eventos.
- Las piezas: API gateway, feature store, base vectorial y registro de modelos.
Confiabilidad desde el diseño
- Reintentos, timeouts, colas y degradación elegante.
- REST frente a gRPC, y respuestas en streaming.
- IDs de petición y presupuestos de reintentos.
- I/O asíncrono para las llamadas al LLM y a la recuperación.
Del notebook al contenedor
- Un servicio en capas: API, dominio y adaptador del modelo.
- Configuración y secretos fuera del código.
- Logs estructurados y endpoints
/healthy/ready. - Artefactos versionados con SHA256, Docker y un primer vistazo a Kubernetes.
Proyecto: Del script al servicio
- Parte de un script de Python que ya funciona en tu máquina.
- Sepáralo en capas y guarda el modelo como artefacto versionado.
- Agrega reintentos, logs estructurados y endpoints de salud.
- Empaquétalo en una imagen de Docker y ejecútalo.
Pipelines de datos y de modelos
Datos confiables
- Ingesta por lotes o en streaming; ETL frente a ELT.
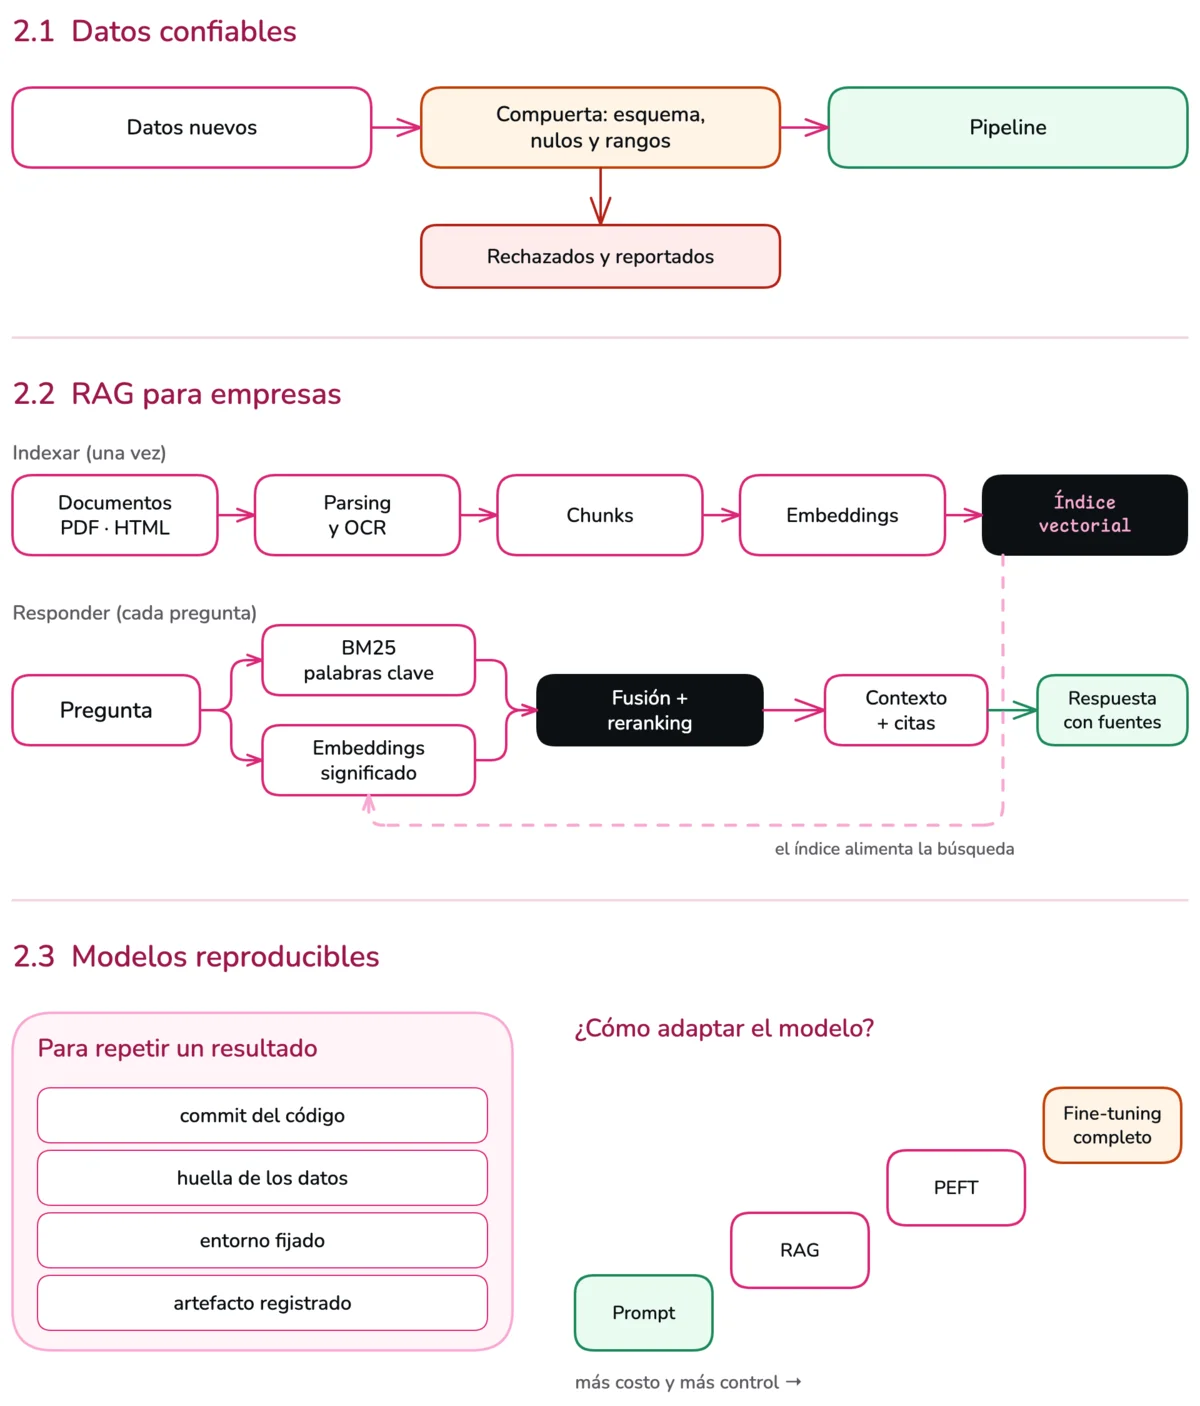
- Compuertas de validación y esquemas obligatorios.
- Linaje, versionado y paridad entre entrenamiento y servicio.
- Detectar fugas de datos (leakage) antes de que lleguen al modelo.
RAG para empresas
- Leer PDF, HTML e imágenes con OCR, y partir los documentos en chunks.
- Base vectorial: índices, upserts y filtros por metadatos.
- Búsqueda híbrida: BM25 + embeddings + reranking; cuándo usar GraphRAG.
- Armar el contexto: orden, límite de tokens y citas.
Modelos reproducibles
- Seguimiento de experimentos con MLflow o Weights & Biases.
- Registro de modelos por etapas y ajuste de hiperparámetros.
- La lista de reproducibilidad: commit, huella de los datos, entorno fijado y artefacto.
- ¿Prompt, RAG, fine-tuning eficiente (PEFT) o fine-tuning completo?
Proyecto: RAG con citas sobre documentos reales
- Carga un conjunto de documentos de una empresa.
- Pártelos en chunks e indexa sus embeddings con metadatos.
- Combina BM25 y búsqueda semántica, y reordena los resultados.
- Responde preguntas citando el documento y la sección de origen.
Servicio, inferencia y optimización
Servir modelos
- Servicios de inferencia dedicados: Triton, TorchServe, Ray Serve, vLLM y SGLang.
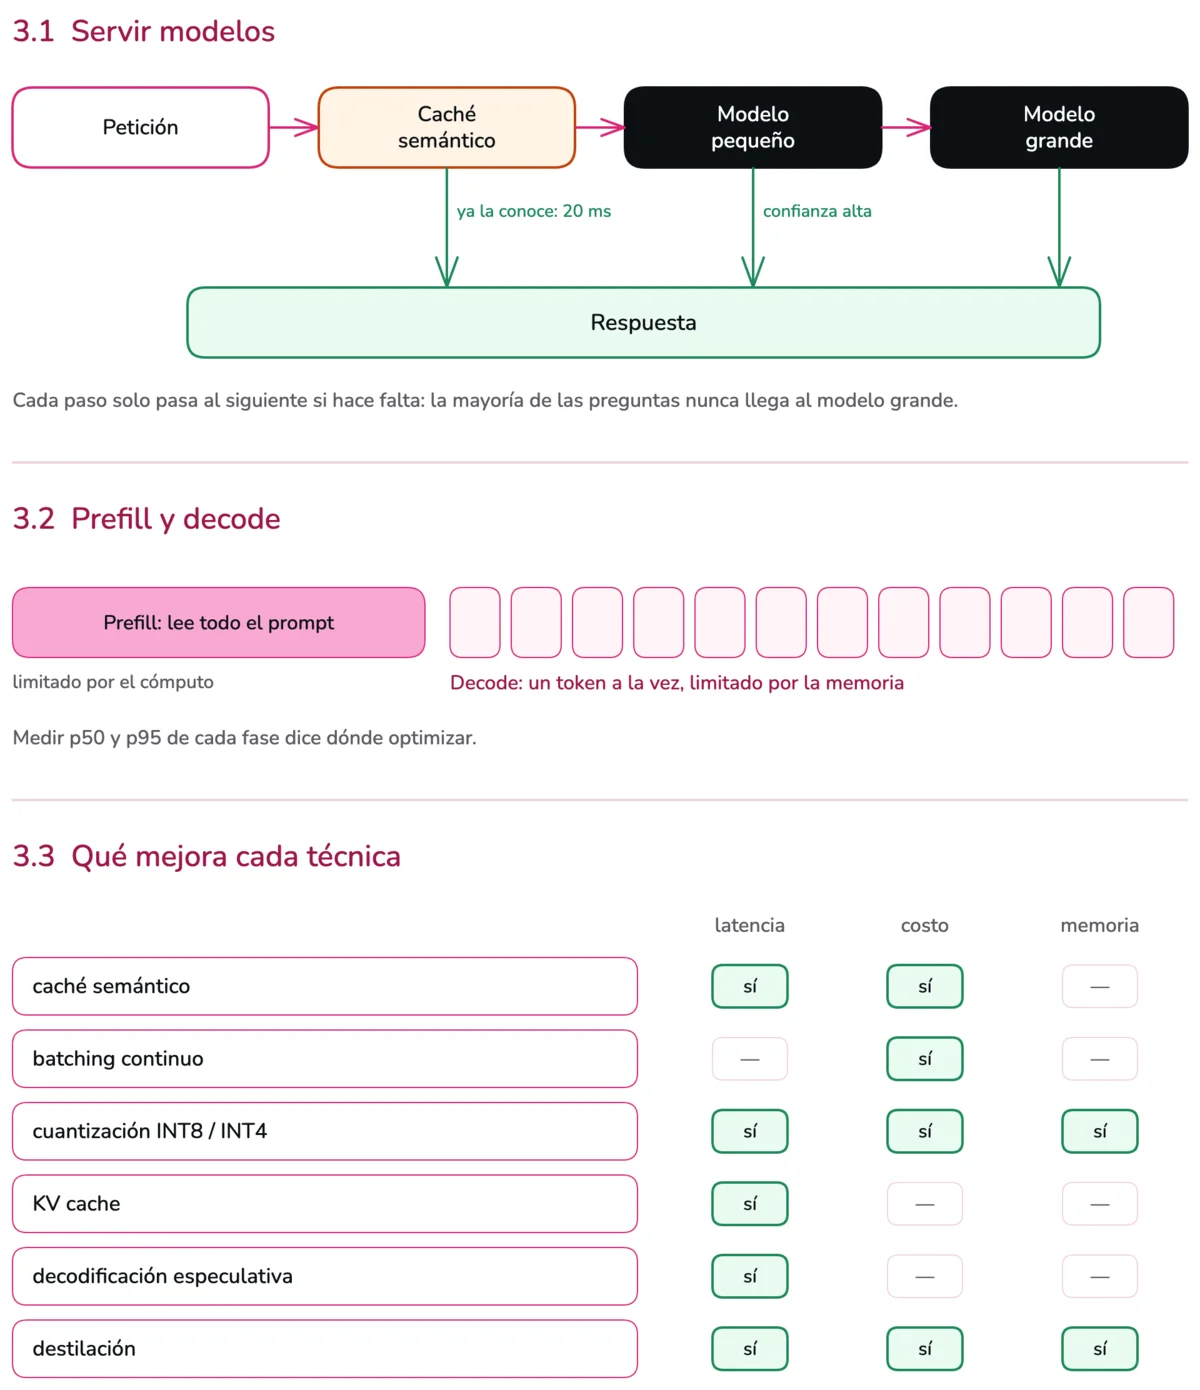
- Prefill frente a decode; inferencia limitada por memoria o por cómputo.
- Topologías: un modelo, un router o una cascada con fallback.
- API administrada o GPU propia: límites, residencia de datos y costo por petición.
Medir y acelerar
- Una línea base con latencia p50 y p95.
- Caché semántico para no pagar dos veces la misma respuesta.
- Batching dinámico frente a batching continuo.
- Señales para el autoescalado.
Modelos más livianos
- Cuantización PTQ y QAT, INT8 e INT4; precisión mixta FP16 y BF16.
- Pruning y destilación de conocimiento.
- Runtimes: ONNX Runtime, TensorRT y OpenVINO.
- KV cache, FlashAttention y decodificación especulativa.
Proyecto: Más rápido y más barato, con números
- Mide la línea base del asistente: p50, p95 y costo por petición.
- Agrega caché semántico y batching.
- Prueba un modelo cuantizado y compara la calidad.
- Presenta un informe antes y después con cada cambio medido.
Evaluación y monitoreo
Evaluar antes de lanzar
- Evaluación offline frente a online.
- Precision, recall, F1, y ROC-AUC frente a PR-AUC.
- Elegir umbrales según el costo de cada error.
- Calibración: diagramas de confiabilidad, Brier, Platt e isotónica.
Evaluar LLMs
- Herramientas de evaluación: RAGAS y DeepEval.
- LLM-as-judge, calibrado contra respuestas revisadas por personas.
- Continuidad en conversaciones de varios turnos.
- Prompts de red team dentro de las pruebas de regresión.
Monitorear y liberar
- Trazas y métricas con OpenTelemetry, Prometheus y Grafana.
- Drift de datos, de concepto, de embeddings y de prompts.
- Alertas por resultados, no solo por errores del servidor.
- Shadow → canary → 100 %, con rollback automático y registro de prompts.
Proyecto: Una compuerta que bloquea versiones malas
- Arma un conjunto de pruebas con casos reales y de red team.
- Mide la calidad con un juez calibrado.
- Publica los resultados en un tablero.
- Bloquea el despliegue cuando la calidad baja del umbral.
Seguridad y gobierno
El mapa de amenazas
- El OWASP Top 10 para aplicaciones con LLMs.
- Prompt injection y jailbreaks.
- Autenticación con tokens y JWT; cifrado en tránsito y en reposo.
- Cómo proteger la base vectorial.
Defensa en capas
- Filtros de entrada y de salida.
- Contratos de salida estructurada.
- Detectar y ocultar datos personales en prompts, logs y respuestas.
- Verificar que cada respuesta se apoye en sus fuentes, y dejar registro de auditoría.
Gobierno
- Model cards, datasheets y auditorías de equidad.
- Explicaciones con citas gracias a RAG.
- El contexto regulatorio: EU AI Act y NIST AI RMF.
- Registro de prompts y políticas: versión, revisión, pruebas, release y rollback.
Proyecto: Un asistente seguro
- Agrega autenticación al asistente.
- Filtra la recuperación según el rol de cada usuario.
- Oculta los datos personales en logs y respuestas.
- Libera los cambios de prompts y políticas con revisión y registro.
Escalar
Plataformas
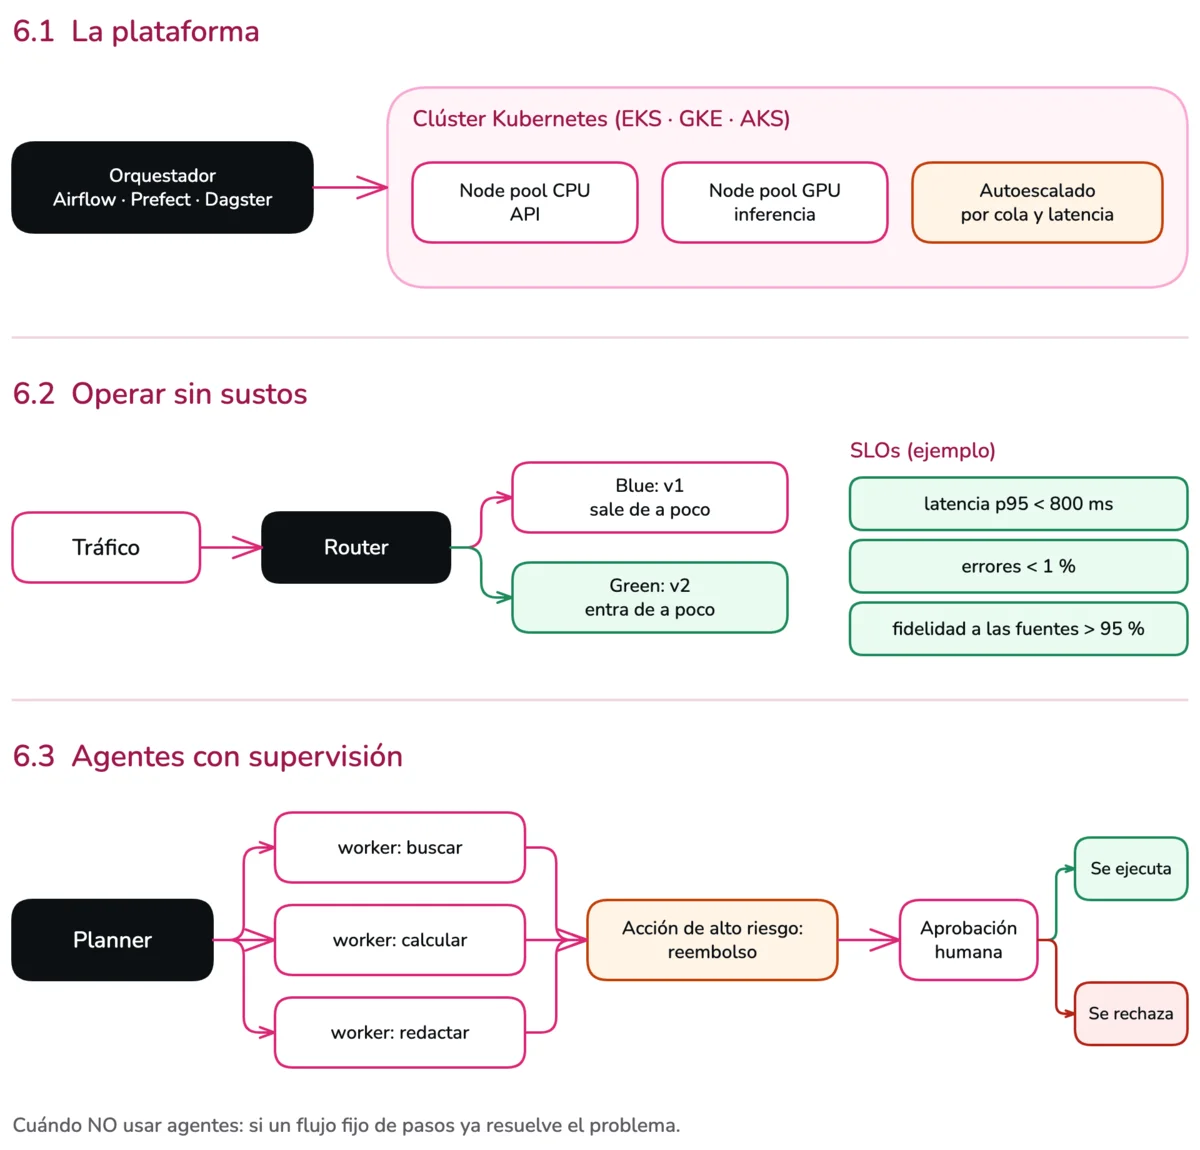
- Kubernetes administrado (EKS, GKE, AKS) o ECS.
- Plataformas de ML: Vertex AI, SageMaker y Azure ML.
- Orquestación: Airflow, Prefect, Dagster, Kubeflow y Ray.
- GPUs: node pools, autoescalado y planeación de capacidad.
Operar sin sustos
- Despliegues canary y blue-green con rollback automático.
- SLOs de latencia, errores y fidelidad a las fuentes.
- Respuesta a incidentes y guardias.
Agentes y casos reales
- El patrón planner/worker y las trazas de agentes.
- Aprobación humana para las acciones de alto riesgo.
- Cuándo NO usar agentes.
- Casos: búsqueda y recomendaciones, riesgo en fintech y asistentes para consumidores.
Proyecto: La plataforma completa
- Despliega el asistente con un release canary.
- Define sus SLOs y un reporte de costos.
- Agrega un agente que pide aprobación humana antes de actuar.
- Simula un incidente y verifica el rollback.
Tu asistente, en producción.
Cada semana le sumas una capa al mismo sistema. Al final tienes un asistente desplegado que puedes medir, defender y operar, y que puedes mostrar en una entrevista o en tu empresa.
Servicio
Una API en capas, un artefacto versionado y una imagen de Docker con health checks y logs.
Conocimiento
RAG con búsqueda híbrida, reranking y citas sobre documentos reales.
Calidad
Evaluaciones, un tablero y una compuerta que bloquea las versiones que empeoran.
Operación
Seguridad por rol, despliegue canary, SLOs y un reporte de costos.
Aprende de quien opera estos sistemas.
Victor Hazbun
Fundador · Bonsai LabsVictor construye software desde 2014. Trabajó como contratista para Priceline y GoDaddy, y como líder técnico formó a desarrolladores con sesiones en pareja, revisiones de código y planes de estudio. Desde 2023 diseña y opera sistemas de IA en producción: agentes, RAG, guardrails y evaluaciones. Hoy dirige Bonsai Labs, donde construye UTMKit y CodeWarden. En este curso enseña cómo diseña, despliega y opera esos sistemas.
Qué necesitas antes de empezar
- Python básico: entornos virtuales,
pipy ejecutar scripts. - Python 3.11 o superior, Git y Docker instalados.
- Ayuda conocer los LLMs, pero no es obligatorio.
Qué recibes al inscribirte
- Seis sesiones en vivo con preguntas y respuestas.
- Grabación de cada sesión y el código de cada demo.
- Una comunidad con tu cohorte para avanzar en grupo.
- Horas de consulta opcionales sobre el material o tu proyecto.
- Certificado de finalización para tu perfil de LinkedIn.
Antes de inscribirte.
¿El curso es en español?
Sí. Las sesiones, los materiales y los proyectos están en español. Las herramientas y su documentación están en inglés, y te explicamos cada término.
¿El curso es en línea?
Sí. Todas las sesiones son en vivo y en línea: te conectas desde Colombia o desde cualquier otro país.
¿Qué necesito saber antes?
Python básico: entornos virtuales, pip y ejecutar scripts. Ayuda haber trabajado con LLMs, pero no es obligatorio.
¿Cuánto tiempo necesito?
Son seis sesiones en vivo de 3 horas, una por semana. Con los proyectos, calcula entre 4 y 7 horas por semana.
¿Qué pasa si no puedo ir a una sesión?
Todas las sesiones se graban. Puedes verlas cuando quieras y seguir con los proyectos igual que el resto de la cohorte.
¿Necesito una cuenta en la nube o una GPU?
No para empezar. Los proyectos corren en tu computador con Docker y herramientas de código abierto. Las plataformas de nube se explican y son opcionales.
¿Mi empresa puede pagar el curso?
Sí. Te enviamos una factura para que la presentes a tu presupuesto de formación.
¿Tienes otra pregunta?
Escríbenos a contact@bonsailabs.io.
Deja de lanzar demos. Empieza a operar sistemas.
Estamos definiendo la fecha y el precio de la primera cohorte. Escríbenos y te avisamos antes de abrir las inscripciones.